概览
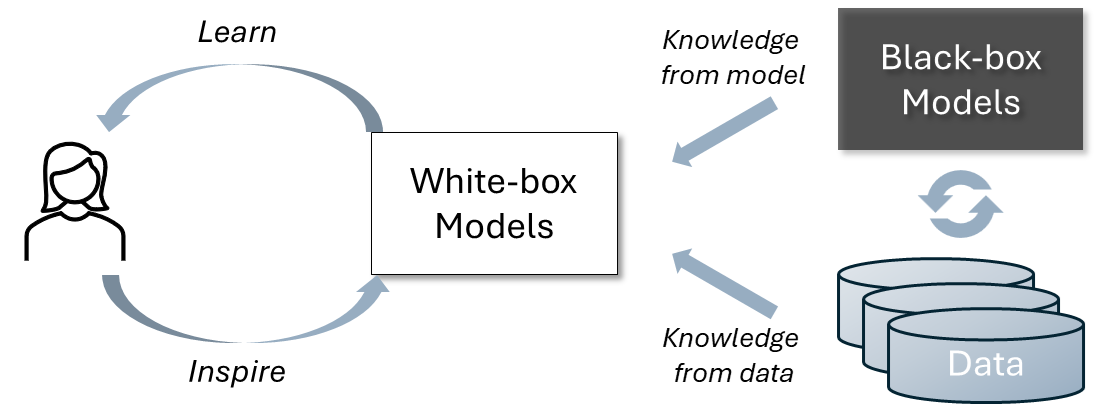
我们研究可解释机器学习,帮助人们理解 AI 模型,并从先进 AI 系统中揭示隐含知识,促进人类学习和科学发现。
- 可解释机器学习:理解时间序列模型、图神经网络和计算机视觉模型。
- 基础模型学习与推理:研究基础模型在训练、适配和推理过程中如何获取、迁移、压缩并保持知识。
- AI 辅助知识发现与学习:借助前沿模型促进学习,并发现模型中的新知识。
时间序列解释
Shapelet 具有直观可解释性,但常受准确率和效率限制;卷积神经网络效果较好,却难以解释。我们证明 Shapelet 本质上等价于一类带平方范数和池化操作的卷积核,并据此提出 ShapeConv,使卷积核本身可作为 Shapelet,用于有监督和无监督时间序列建模 [Qu et al., ICLR 2024]1。
图神经网络解释
给定训练好的图神经网络,解释器需要找出对预测最关键的子图。RG-Explainer 用强化学习逐步从当前子图边界加入节点,在遵循消息传递机制的同时生成连通解释子图 [Shan et al., NeurIPS 2021]2。面向动态图,我们提出 T-GNNExplainer,其 Explorer-Navigator 框架在真实与合成数据集上显著提升解释质量 [Xia et al., ICLR 2023]3。
基础模型理解与适配
我们的模型解释研究已从任务专用网络拓展到基础模型适配。跨层概念分析揭示视觉提示调优如何改变预训练模型不同层次的语义表示 [Wang et al., ICLR 2026]4。Learning to Instruct 让模型为视觉指令调优自动构造有效指令 [Zhou et al., NeurIPS 2025]5;推理驱动的多模态学习则利用显式推理提升领域泛化能力 [Xu et al., ICLR 2026]6。
高效知识获取与推理
我们研究如何降低大模型学习和调用知识所需的计算与内存成本。Chain-of-Model 把多个模型组织为渐进式语言模型学习过程 [Wang et al., NeurIPS 2025]7;景观扩展方法加速大语言模型微调中的块坐标下降 [Luo et al., NeurIPS 2025]8;GRASS 自适应选择训练层,实现内存高效的全参数微调 [Tian et al., ACL 2026 Findings]9;Alloc-MoE 则在层与 token 两个粒度分配专家激活预算,提高混合专家模型的推理效率 [Liu et al., ACL 2026]10。
稳健推理与生成学习
可靠地使用知识不能只看最终答案是否正确。我们分析自蒸馏何时会抑制有用的不确定性表达,并损害分布外推理 [Kim et al., COLM 2026]11;在大语言模型强化学习中,限制低概率 token 对优化过程的过度主导 [Yang et al., ICLR 2026]12;在生成模型中,通过容量调控改善类别不平衡数据上的扩散模型学习 [Hong et al., ICLR 2026]13。
图知识与相似性
在图学习方向,我们将操作代价与全局匹配依赖整合到一步对齐中,以更准确、高效地计算灵活图相似度 [Liu et al., ICDE 2026]14。
参考文献
-
Eric Qu et al. CNN Kernels Can Be the Best Shapelets. ICLR 2024. ↩
-
Caihua Shan et al. Reinforcement Learning Enhanced Explainer for Graph Neural Networks. NeurIPS 2021. ↩
-
Wenwen Xia et al. Explaining Temporal Graph Models through an Explorer-Navigator Framework. ICLR 2023. ↩
-
Yubin Wang et al. Exploring Interpretability for Visual Prompt Tuning with Cross-layer Concepts. ICLR 2026. ↩
-
Zhihan Zhou et al. Learning to Instruct for Visual Instruction Tuning. NeurIPS 2025. ↩
-
Zhipeng Xu et al. Reasoning-Driven Multimodal LLM for Domain Generalization. ICLR 2026. ↩
-
Xiaohua Wang et al. Chain-of-Model Learning for Language Model. NeurIPS 2025. ↩
-
Qijun Luo et al. Accelerating Block Coordinate Descent for LLM Finetuning via Landscape Expansion. NeurIPS 2025. ↩
-
Kaiyuan Tian et al. GRASS: Gradient-based Adaptive Layer-wise Importance Sampling for Memory-efficient Large Language Model Fine-tuning. ACL 2026 Findings. ↩
-
Baihui Liu et al. Alloc-MoE: Budget-Aware Expert Activation Allocation for Efficient Mixture-of-Experts Inference. ACL 2026. ↩
-
Jeonghye Kim et al. Why Does Self-Distillation (Sometimes) Degrade the Reasoning Capability of LLMs? COLM 2026. ↩
-
Zhihe Yang et al. Do Not Let Low-Probability Tokens Over-Dominate in RL for LLMs. ICLR 2026. ↩
-
Feng Hong et al. Improving Diffusion Models for Class-imbalanced Training Data via Capacity Manipulation. ICLR 2026. ↩
-
Zhouyang Liu et al. Rethinking Flexible Graph Similarity Computation: One-step Alignment with Global Guidance. ICDE 2026. ↩